硅光子学与光互连技术:攻克 2026 年人工智能数据中心带宽与功耗之墙
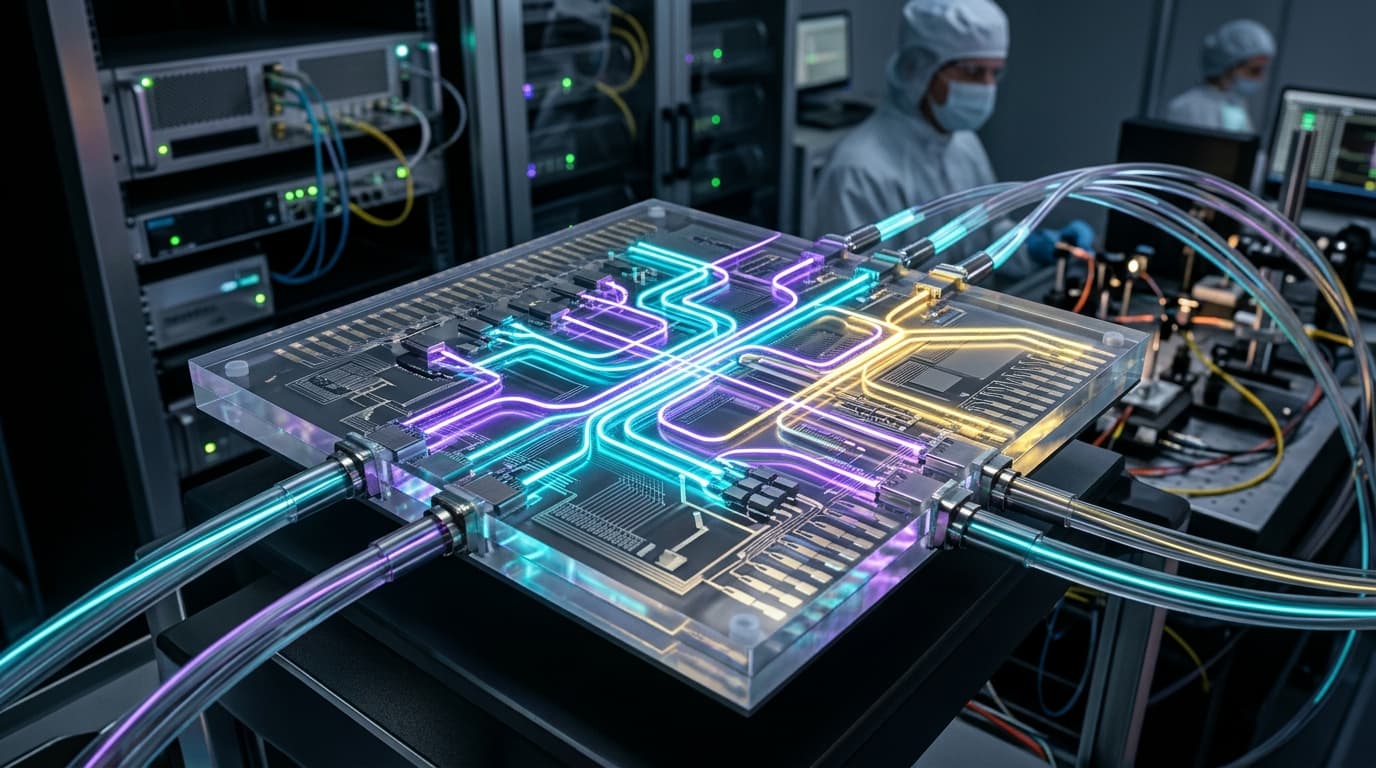
快速解答 (Quick Answer): 前沿人工智能大模型的指数级扩张遭遇了严苛的物理天花板——铜互连之墙 (Copper Interconnect Wall)。在成千上万个 GPU 组成的超级集群中,传统铜缆电气布线即使在短短两米内也会产生灾难性的热耗散与严重信号衰减,导致数据中心高达 30% 的电力纯粹被消耗在数据搬运上。在 2026 至 2027 年,硅光子学 (Silicon Photonics) 与共封装光学 (Co-Packaged Optics, CPO) 的商业化成熟,以相干激光光子取代电气电子,直接在半导体基板上实现光信号路由。这一根本性变革将传输能耗削减了 10 倍(降至皮焦耳每比特以下,Sub-pJ/bit),彻底消除网络延迟瓶颈,奠定了百亿亿次 (Exascale) 分布式 AI 训练架构的基石。
随着人工智能模型突破数十万亿参数规模,数据中心工程设计的核心限制已经从单纯的计算算力 (FLOPS) 转移到了互连带宽。现代前沿大语言模型与专家混合模型 (MoE) 架构要求数十万个加速计算芯片之间以微秒级超低延迟实现全互联通信。
几十年来,数据中心工程师一直依赖连接在交换机上的传统插拔式光模块与铜缆。然而,当单通道速率超过 1.6 Tbps 时,铜导线的电阻率会将其变成微型发热器,带来无法接受的严重信号失真与热降频。
硅光子学通过在标准硅基 CMOS 半导体晶圆上直接制造微米级光波导、调制器与光电探测器,彻底消除了这一物理瓶颈,让数据以光速飞驰。
架构演进:电气铜缆互连 vs. 共封装硅光子学 (CPO)
为了深入理解硅光子学如何重塑超级计算机网络拓扑,让我们对比 GPU 机架内部的架构转变:
传统电气铜线互连架构(受限于热耗散与传输距离):
[GPU 芯片核心] ──► [长距离 PCB 高频走线] ──► [传统插拔式光模块] ──► [粗重铜缆]
                        │ (剧烈发热,每比特能耗高达 15-25 pJ/bit)
                        ▼
             (在 >1.6 Tbps 速率下,超过 2 米即发生严重信号衰减)

共封装光学 (CPO) 硅光子架构:
[GPU 计算芯粒 (Chiplet)]
         │ (微米级超短芯片互连桥接)
         ▼
[硅基光学引擎 (光波导 + 微环调制器)]
         │ (相干多波长激光光路传输)
         ▼
[直接光纤互连网络 (传输 100 米以上,能耗低于 1 pJ/bit)]
核心指标对比矩阵:电气铜缆 vs. 硅光子互连技术
下表对比了传统直连铜缆 (DAC) 与下一代硅光子互连技术的物理与运营关键指标:
| 评估指标 / 架构特性 | 传统直连铜缆 (DAC) | 共封装光学 (CPO) 硅光子学 |
|---|---|---|
| 每比特能量消耗 | 15 至 25 皮焦耳/比特 (pJ/bit) | 1.0 至 2.5 皮焦耳/比特(下一代低于 1 pJ) |
| 最高传输距离 | 在 800G / 1.6T 速率下通常小于 2 米 | 超过 100 至 500 米且无需有源重定时中继器 |
| 线缆体积与重量 | 线缆极其厚重僵硬,严重阻塞机柜通风散热风道 | 超轻量、微型柔韧的光纤带阵列 |
| 网络时延表现 | 依赖高功耗 DSP 重定时器,引入额外串行化延迟 | 光速光程传输,物理上免除 DSP 复杂重定时 |
| 半导体制造工艺 | 传统专业铜线抽丝与机械拼装封装工艺 | 标准 CMOS 硅半导体制造代工线 (TSMC / Intel) |
| 机房散热能耗影响 | 产生大量废热,需大功率风扇与复杂液冷辅助 | 显著降低热负荷,直接对接冷板式液冷系统 |
推动 2026–2027 年硅光子学落地的三大技术突破
三大关键半导体技术突破,将硅光子学从物理实验室推向了主流规模化生产的数据中心:
1. 共封装光学 (CPO) 与 2.5D/3D 高级封装
传统光模块作为离散器件插在网络交换机的外表面板上。电信号必须经过数十厘米高损耗的 PCB 走线才能转换为光信号。CPO 技术通过将硅光学引擎直接贴装在与 GPU 或交换机 ASIC 相同的基板中介层上,彻底抹去了这段铜走线距离。将电传输距离缩短至 1 毫米以内,使得输入/输出 (I/O) 功耗锐减超过 70%。(阅读关于 神经形态芯片与边缘计算架构 的深度剖析。)
2. 多波长微环谐振腔 (Micro-Ring Resonators)
为了在不无限增加物理光纤数量的前提下实现带宽最大化,现代光学引擎采用微环谐振腔实现超密集波分复用 (DWDM)。单个光波导可同时引导 16 至 32 种不同波长的激光光束,每条光束承载 100 Gbps 速率,使单根发丝细的光纤即可承载 3.2 Tbps 的双向传输带宽且彼此零串扰。(了解关于 光学神经网络与光子 AI 计算 的前沿探索。)
3. 外置连续波激光光源 (External Laser Sources, ELS)
早期的光电集成芯片饱受激光器可靠性之苦,原因在于相邻算力芯片产生的高温会加速激光二极管老化。2026 年的业界标准采用了盲插式外置激光光源 (ELS) 模块,将其安装在温度较低的机箱前部,通过保偏光纤将洁净的连续波 (CW) 激光能量导入计算芯片封装内部。即使某个激光器发生故障,亦可在数秒内完成热插拔替换,完全无需中断 GPU 正在进行的训练任务。
对数据中心宏观格局的深远影响:PUE 与兆瓦级电力节约
对于超大规模云厂商和主权 AI 基础设施运营者而言,硅光子学已经成为决定生存发展的必然选择:
- 突破数据中心电网配额瓶颈: 现代吉瓦级 (GW) AI 产业园区往往受到地方电网供电上限的严格制约。通过在海量东西向集群通信中每比特削减 15 至 20 皮焦耳,硅光子技术可为单座超算中心节省数十兆瓦的电力消耗——将节省下来的宝贵电力直接转化为算力吞吐。(拓展阅读:主权 AI 基础设施宏观经济与战略布局。)
- 真正的内存池化解耦 (Optical CXL): 得益于亚纳秒级的光速传输时间,GPU 可以跨机架访问远端解耦的高带宽内存 (HBM) 与 DDR5 内存池,其速度就如同访问本地内存总线一样,极大释放了千亿/万亿级 MoE 模型的显存效率。
- 集群物理规模线性扩展: 高速光链路打破了机房物理距离半径的死板限制。GPU 服务器可以跨越楼层、分布式模块化部署,同时维持全局统一的超低延迟互连纤维结构。
常见问题解答 (FAQ)
硅光子学与传统光模块之间最核心的区别是什么?
传统光模块是独立的插拔式模块,依赖繁复的手工微光学装配并插在交换机面板上,依赖长距离高损耗 PCB 走线。而硅光子学将波导、调制器、探测器等所有光学元器件直接集成于硅半导体芯片内部,由成熟的标准晶圆代工厂自动化生产,具有极高集成度、大幅降低的成本,并能与计算处理器实现紧密共封装。
为什么不能简单地将铜缆加粗来应对更高的数据速率?
将铜缆导体加粗会带来巨大的重量和物理硬度,导致服务器机柜内部线缆密不透风,严重阻断气流通道。更关键的是在超高频(>100 GHz)工况下,集肤效应 (Skin Effect) 迫使电子仅在导体表层极薄区域流动,引发指数级信号损耗,这绝非单纯加厚铜层所能解决。
硅光子技术目前已经在商业生产环境中落地部署了吗?
是的。截至 2026 年,全球主流 AI 算力服务商、芯片制造龙头以及网络基础设施巨头(包括 NVIDIA、博通、英特尔、台积电等)已经完成从实验室验证到商用量产的跨越,在领先的超算 AI 集群中广泛商用 1.6T 与 3.2T 级别的共封装光学 (CPO) 及硅光模块。
硅光子学如何促进绿色低碳与 AI 可持续发展?
在现代大型超算集群中,数据搬运传输与辅助散热能耗占到了总电力的近 40%。硅光子学将互连能耗降低高达 80%,并极大减少机房热量散发,从而直接降低数据中心电能使用效率 (PUE) 指标,每年可为单一超算集群节约数千万度电能。