光子神经形态计算:打破下一代人工智能芯片的能量墙
随着基础模型的参数规模超过数万亿,半导体工程面临着一个难以逾越的物理边界:电子互连瓶颈。虽然晶体管密度通过亚 2 纳米环栅 (GAA) 架构不断提高,但铜线的电阻和电容会产生严重的热耗散和寄生电容。在现代人工智能超级集群中,超过 60% 的系统总功率没有浪费在张量计算上,而只是在电路板上传输比特。
光子神经形态计算代表了打破这堵能量墙所需的量子飞跃。通过用以光速穿过硅波导的定向光子取代铜线和电子,光学计算处理器以接近零的热量和亚皮秒延迟执行线性矩阵数学。
光学神经形态芯片如何利用光进行计算
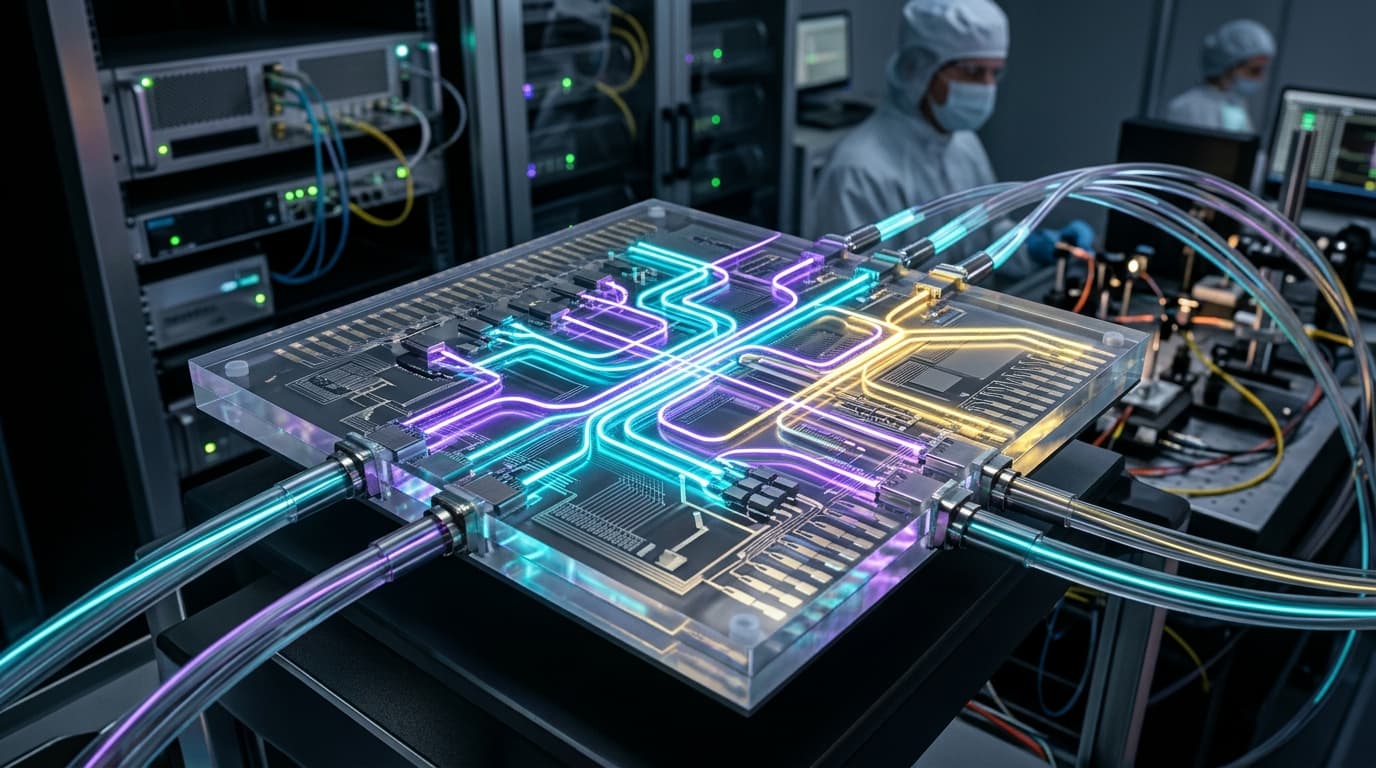
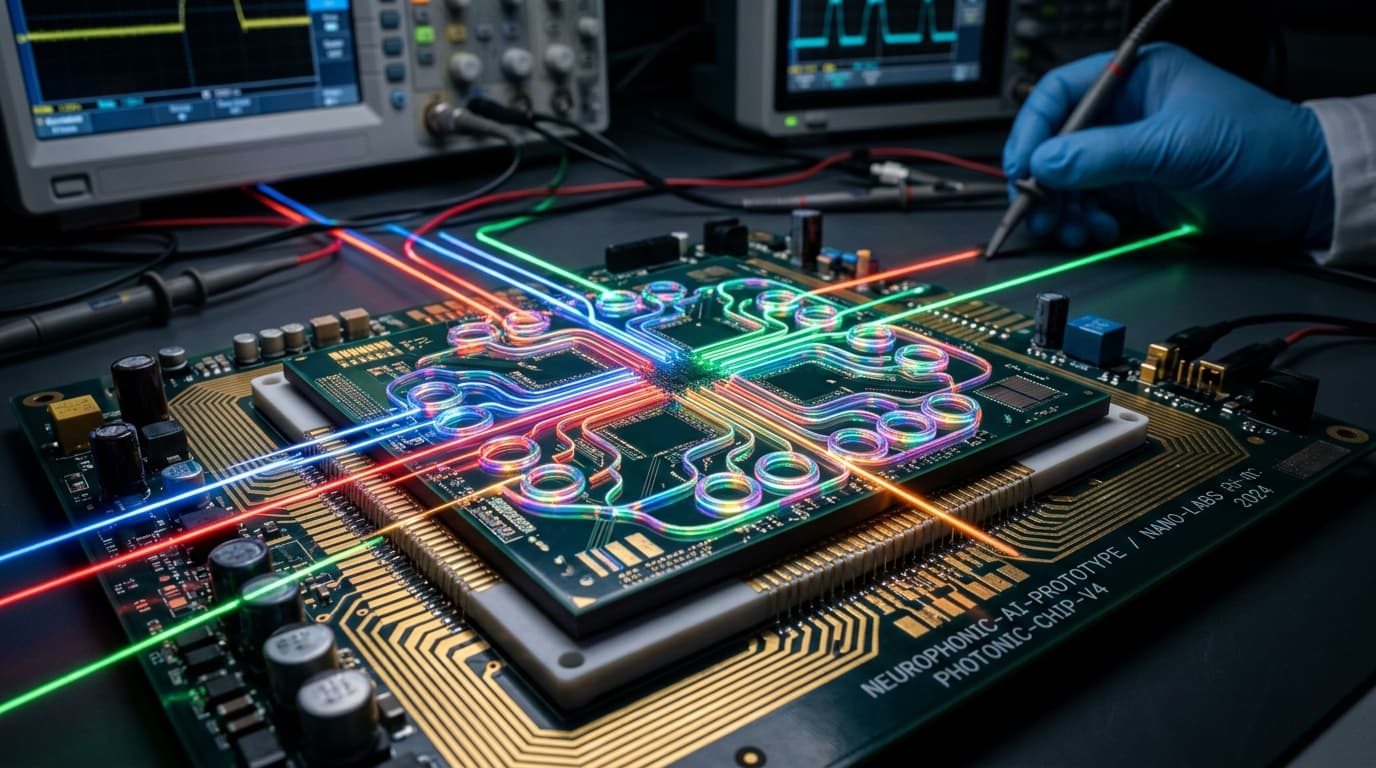
光学神经处理器的核心是硅光子集成电路(PIC)。光子处理器不是通过数十亿个硅逻辑门的开关来执行浮点运算,而是操纵光的基本波特性,例如相位、幅度和波长。
1. 马赫-曾德干涉仪 (MZI) 网格
光学矩阵乘法是通过马赫曾德干涉仪的可编程网格物理执行的。通过应用微观热或电光相移,传入的相干激光束会发生相长或相消干涉。当光穿过玻璃波导时,这种物理光学干涉立即执行任意酉矩阵变换。
2. 微环谐振器 (MRR) 和 WDM
波分复用 (WDM) 可以使数百个离散光载波信号(每个信号的颜色波长略有不同)沿着单个微观硅波导同时传播。微环谐振器以亚微米精度过滤和调制这些波长,从而允许并行矩阵卷积,而不会造成物理线路拥塞。
3. 共封装光学器件 (CPO)
传统 AI 加速器通过 PCIe 通道和铜质 SerDes 电缆损失了驱动电信号的大量能量。共同封装的光学器件将光子收发器直接安装在与先进计算硅相同的基板上,消除了厚重的铜迹线并将互连功耗降低了 75% 以上。
性能比较:硅光子与经典电子
| 基准指标 | 经典高端GPU/TPU | 光子神经形态加速器 |
|---|---|---|
| 计算延迟(MAC 单位) | 0.5 – 1.5 纳秒 | < 1.0 皮秒(光的飞行) |
| 能源消耗 | ~10–50 皮焦耳/触发器 | ~0.05–0.2 皮焦/MAC |
| 互连带宽 | 铜 SerDes 有限(~1.6 Tbps) | 光波导(> 100 Tbps 聚合) |
| 峰值负载时的散热 | 极端(需要液氮/直接冷冻水) | 低(热耗散与激光源隔离) |
| 信号衰减 | 超过厘米的高 RC 延迟 | 数据中心机架上的衰减可以忽略不计 |
战略性现实应用
1.实时自主防御和雷达信号处理
相控阵雷达系统和电子战套件每毫秒生成数百万个原始射频 (RF) 样本。电子微处理器无法在没有严重延迟的情况下数字化和处理这种洪水。光子处理器将模拟射频波直接转换为光信号,立即识别敌方雷达信号和导航威胁。
2. 宏观经济规模的超大规模变压器推理
运行前沿多模态推理模型会造成巨大的市政电网压力。采用光子加速器的超大规模数据中心可以在标准变电站范围内运行连续的实时视频和音频推理引擎,每年节省数百万美元的运营冷却预算。
3. 神经形态超低功耗边缘传感器
集成到医疗内窥镜传感器、卫星遥测吊舱和智能机器人关节中的微型光学芯片可以在本地对传感输入进行分类,而无需通过易受攻击的无线电连接传输未加密的原始数据包。
常见问题解答 (FAQ)
光子处理器可以像标准 CPU 一样执行通用计算吗?
不会。光子硬件是一种专用加速器,从根本上是为线性代数、傅里叶变换和矩阵乘法量身定制的。非线性激活函数和存储操作仍然在混合共同封装的电子层中进行管理。
大规模采用光子芯片的最大障碍是什么?
精密激光源集成、纳米级光纤到芯片封装对准公差以及微环谐振器的热漂移稳定是目前正在解决的主要工业制造挑战。
光学计算机会让 GPU 过时吗?
光学处理器将充当协处理器,而不是取代 GPU。未来的计算节点将采用混合架构:执行大量张量卷积的高吞吐量光子引擎,加上处理内存协调和系统编排的电子逻辑。