실리콘 포토닉스와 광 인터커넥트: 2026년 AI 데이터센터의 대역폭 및 전력 장벽 극복 전략
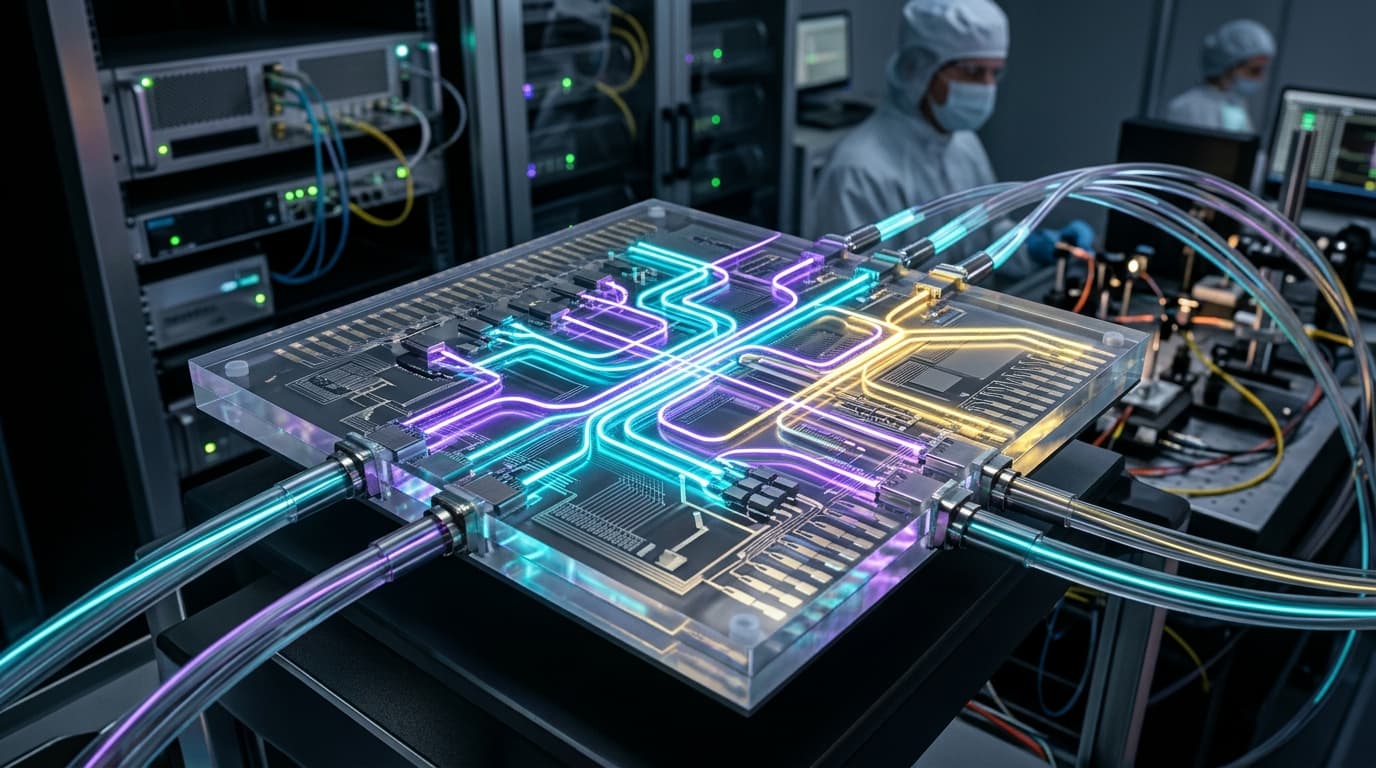
빠른 답변: 프론티어 인공지능 모델의 기하급수적인 연산 규모 확장은 거대한 물리적 장벽인 **'구리선 인터커넥트의 한계(Copper Wall)'**에 부딪혔습니다. 수만 개의 GPU가 연결된 초거대 클러스터에서 기존 전기 구리 배선은 2미터의 거리에서도 극심한 신호 감쇠와 발열을 일으켜, 데이터센터 총 전력의 최대 30%를 단순 데이터 전송에만 소모하고 있습니다. 2026~2027년, 상용화 궤도에 진입한 **실리콘 포토닉스(Silicon Photonics)**와 CPO(Co-Packaged Optics) 기술은 반도체 패키지 위에서 전자를 간섭 없는 일관성 레이저 광자(빛)로 대체합니다. 이를 통해 데이터 전송 에너지를 10분의 1(비트당 서브 피코줄 수준)로 절감하고, 네트워크 지연을 극적으로 낮추어 엑사스케일 분산 AI 학습을 현실화하고 있습니다.
인공지능 모델의 파라미터가 수십조 개를 넘어서면서, 차세대 데이터센터 공학의 병목은 순수 프로세서 연산력(FLOPS)에서 칩 간 상호 연결 대역폭으로 이동했습니다. 현대의 거대 언어 모델(LLM)과 MoE(Mixture-of-Experts) 신경망은 수십만 개의 가속기 사이에서 마이크로초 단위의 초저지연으로 방대한 텐서 데이터를 끊임없이 송수신(All-to-All 통신)해야 합니다.
수십 년간 데이터센터 네트워크는 스위치 전면에 장착하는 착탈식 광 트랜시버와 구리 케이블에 의존해 왔습니다. 하지만 채널당 1.6Tbps를 초과하는 초고속 전송 영역에서는 전기적 저항으로 인해 구리선이 고열을 방출하며 심각한 신호 왜곡을 유발합니다.
실리콘 포토닉스는 표준 실리콘 반도체 제조 공정(CMOS) 라인에서 미세 광도파로, 광변조기, 광검출기를 칩 위에 직접 식각하여 빛의 속도로 데이터를 송수신함으로써 이 근본적인 병목을 해결합니다.
아키텍처의 진화: 전기 구리 배선 vs 패키지 결합 광학(CPO)
실리콘 포토닉스가 AI 슈퍼컴퓨터의 네트워크 토폴로지를 어떻게 근본적으로 혁신하는지 비교해 보겠습니다.
기존 구리 인터커넥트 방식 (열 손실 및 전송 거리의 한계):
[GPU 연산 다이] ──► [긴 기판 회로 PCB 트레이스] ──► [플러그형 트랜시버] ──► [구리 케이블]
                            │ (극심한 발열 및 15~25 pJ/bit 에너지 소모)
                            ▼
               (2미터 이상 전송 시 고주파 신호 감쇠로 통신 실패)

CPO(Co-Packaged Optics) 실리콘 포토닉스 아키텍처:
[GPU 연산 칩렛]
         │ (서브밀리미터 수준의 초단거리 실리콘 인터포저 연결)
         ▼
[실리콘 광학 엔진 (미세 광도파로 + 마이크로 링 변조기)]
         │ (간섭 없는 다중 파장 레이저 빛)
         ▼
[직접 광섬유 인터커넥트 (100미터 이상 장거리에서도 1 pJ/bit 미만 고효율)]
전략적 비교 매트릭스: 구리 케이블 vs 실리콘 포토닉스 인터커넥트
아래 표는 기존 구리 배선 솔루션과 차세대 실리콘 포토닉스 CPO 아키텍처의 물리적 및 운영 특성을 대조한 것입니다.
| 평가 지표 및 물리적 특성 | 기존 직접 연결 구리 배선 (DAC) | 차세대 CPO 기반 실리콘 포토닉스 |
|---|---|---|
| 비트당 전송 에너지 소모량 | 15 ~ 25 피코줄 / 비트 (pJ/bit) | 1.0 ~ 2.5 피코줄 / 비트 (차세대는 1pJ 미만) |
| 초고속 신호 최대 전송 거리 | 800G / 1.6T 전송 시 2미터 이내로 제한 | 신호 증폭기 없이도 100 ~ 500미터 이상 전송 |
| 케이블 무게 및 랙 점유 부피 | 매우 두껍고 무거워 랙 후면의 냉각 기류를 차단 | 극도로 가볍고 유연한 마이크로 광섬유 리본 채택 |
| 데이터 전송 지연 시간(Latency) | 복잡한 DSP 리타이머 칩 구동으로 지연 누적 | 빛의 이동 속도로 전송되며 DSP 리타이머 생략 |
| 반도체 생산 파운드리 공정 | 특수 금속 가공 및 개별 부품 조립 공정 | 표준 상용 첨단 CMOS 파운드리 생산 라인 (TSMC / Intel) |
| 데이터센터 냉각 시스템 부하 | 고출력 공랭 팬 및 강력한 액체 냉각 장치 필수 | 열 발생량이 현저히 낮아 직접 칩 액체 냉각과 완벽 호환 |
2026~2027년 실리콘 포토닉스를 가속화하는 3대 핵심 혁신
실리콘 포토닉스가 연구실 수준의 프로토타입에서 글로벌 대규모 상용 데이터센터로 도입될 수 있었던 배경에는 세 가지 핵심 기술 진보가 있습니다.
1. 패키지 결합 광학(CPO)과 2.5D/3D 이종 집적
과거의 광 트랜시버는 스위치 전면 패널에 장착되는 독립형 모듈이었습니다. 전기 신호가 광 신호로 변환되기 전 기판(PCB) 배선을 따라 수십 센티미터를 이동해야 했습니다. CPO는 실리콘 광학 엔진을 GPU나 스위치 ASIC과 동일한 실리콘 기판(인터포저) 위에 직접 얹는 방식입니다. 전기 신호 이동 거리를 1밀리미터 이내로 단축함으로써 I/O 인터페이스의 전력 소비를 70% 이상 절감했습니다. (관련 기사: 뉴로모픽 칩과 온디바이스 에지 컴퓨팅)
2. 고밀도 파장 분할 다중화(DWDM)용 마이크로 링 공진기
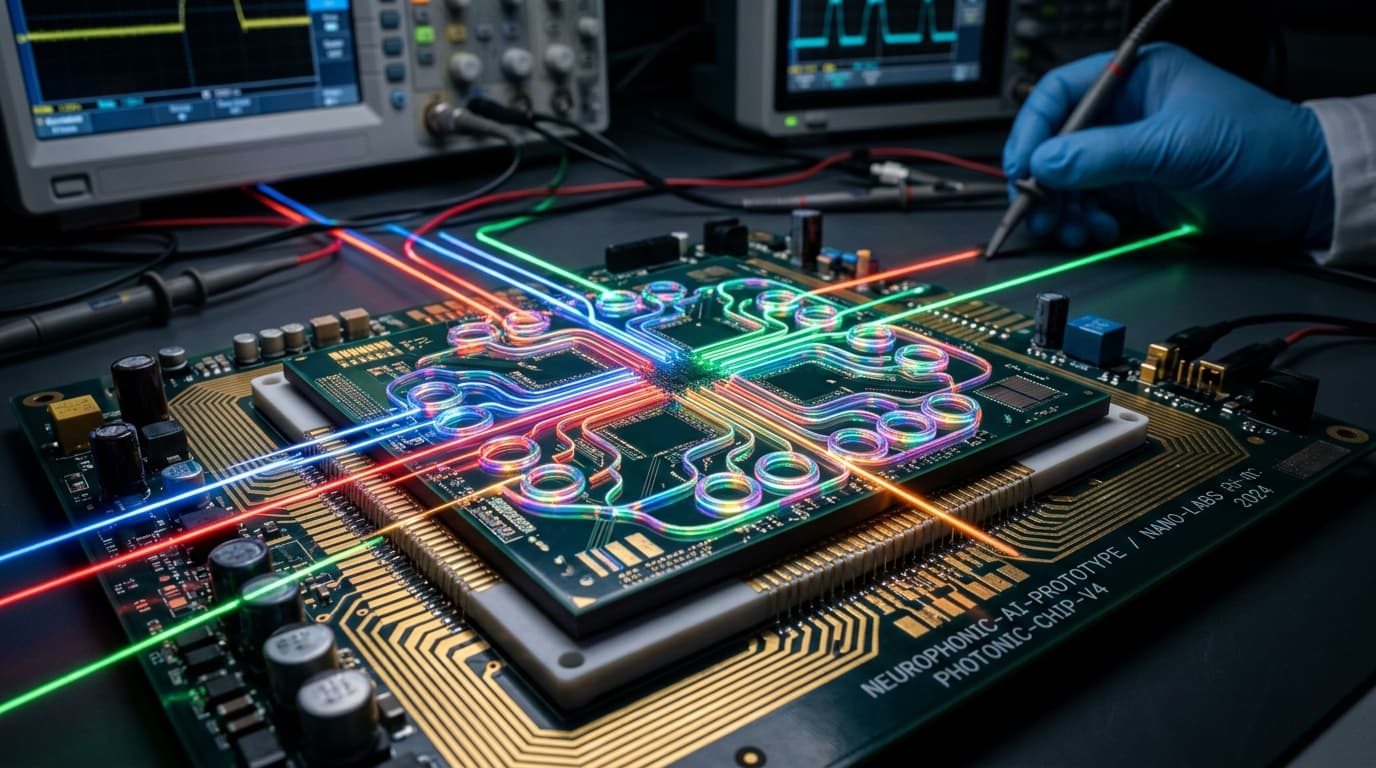
광섬유 케이블의 가닥수를 무한정 늘리지 않고 대역폭을 극대화하기 위해, 현대 광 엔진은 초소형 마이크로 링 공진기를 사용합니다. 단 하나의 미세 광도파로에 각기 다른 16~32개의 레이저 파장을 동시에 통과시키고 각각 100Gbps로 변조하여, 단 한 가닥의 얇은 광섬유로 **초당 3.2테라비트(Tbps)**의 양방향 데이터를 상호 간섭 없이 전송합니다. (관련 기사: 광 신경망과 포토닉 AI 혁신)
3. 외장형 연속 발진 레이저 광원(ELS) 모듈화
초기 광 집적 칩은 고발열 GPU 연산 다이의 뜨거운 열기로 인해 레이저 다이오드가 쉽게 손상되는 신뢰성 문제를 겪었습니다. 2026년 표준 아키텍처는 레이저 발진부를 연산 칩에서 분리하여, 서버 랙 전면의 시원한 공기 흡입부에 탈착식 ELS(External Laser Source) 모듈로 배치합니다. 편광 유지 광섬유를 통해 빛만을 연산 패키지로 공급하므로, 레이저가 고장 나더라도 GPU 작업을 중단하지 않고 수초 만에 핫스왑 교체가 가능합니다.
데이터센터 거시적 파급 효과: 전력 효율(PUE) 및 메가와트 절감
글로벌 하이퍼스케일러와 소버린(주권) AI 인프라 운영사에게 실리콘 포토닉스는 단순한 성능 향상을 넘어선 비즈니스 생존 문제입니다.
- 전력 그리드 한계의 돌파: 기가와트 규모의 대규모 AI 데이터센터는 해당 지역 전력망의 용량 한계에 직면해 있습니다. 실리콘 포토닉스를 통해 테라바이트급 클러스터 데이터 전송에 드는 전력을 비트당 15~20피코줄 절감함으로써 수십 메가와트(MW)의 유휴 전력을 확보할 수 있으며, 이 전력을 순수 AI 학습 연산에 재배치할 수 있습니다. (관련 기사: 거시경제 자산으로서의 소버린 AI 인프라)
- 진정한 메모리 풀링(Optical CXL) 구현: 나노초 미만의 광학 전송 지연 시간 덕분에 GPU는 서로 다른 랙에 분산된 HBM 및 DDR5 메모리 풀을 마치 메인보드 로컬 버스에 직결된 것처럼 초고속으로 읽고 쓸 수 있어 초거대 MoE 모델의 메모리 낭비를 없앱니다.
- 데이터센터의 물리적 공간 제약 탈피: 초고속 광 링크는 케이블 길이의 물리적 한계를 해소합니다. GPU 서버 랙들을 복층 건물이나 독립된 모듈형 컨테이너에 분산 배치하더라도 마치 한 랙에 모여 있는 것처럼 초저지연 네트워크 패브릭을 유지할 수 있습니다.
자주 묻는 질문 (FAQ)
실리콘 포토닉스는 기존 착탈식 광 트랜시버와 어떻게 다른가요?
기존 광 트랜시버는 개별 광학 렌즈 부품을 수작업에 가깝게 조립한 독립형 금속 모듈로 스위치 외부에 장착되며, 기판의 긴 전기 배선을 거치며 에너지 손실이 큽니다. 반면 실리콘 포토닉스는 도파로, 변조기, 수광기 등 모든 광학 소자를 기존 실리콘 반도체 파운드리 라인에서 마이크로 칩 형태로 일체화 생산하므로 대량 양산이 가능하고 비용이 훨씬 저렴하며 GPU 연산 다이 바로 옆에 밀착 패키징할 수 있습니다.
구리 케이블을 더 두껍게 만들어서 속도를 올릴 수는 없나요?
구리선의 직경을 늘리면 무게가 급증하여 서버 랙 배선이 불가능해지고 공랭 냉각을 위한 공기 흐름을 완전히 차단하게 됩니다. 더 치명적인 물리적 한계는 100GHz 이상의 초고주파에서 전자가 도체의 표면으로만 흐르는 **표피 효과(Skin Effect)**가 발생하여 금속을 아무리 두껍게 만들어도 신호 감쇠를 막을 수 없다는 점입니다.
실리콘 포토닉스는 현재 실제 상용 데이터센터에 도입되어 있나요?
네, 도입되어 있습니다. 2026년 기준 NVIDIA, Broadcom, Intel, TSMC 등 글로벌 반도체 및 네트워크 선도 기업들이 1.6T 및 3.2T 대역폭의 패키지 결합 광학(CPO) 엔진 및 포토닉 인터커넥트를 대량 생산하고 있으며, 프론티어 AI 학습용 슈퍼컴퓨팅 클러스터 현장에 본격 배포되고 있습니다.
실리콘 포토닉스는 AI 데이터센터의 탄소 배출 절감에 어떻게 기여하나요?
AI 클러스터가 소모하는 총 전력의 약 40%는 데이터 전송과 냉각 시스템 가동에 사용됩니다. 실리콘 포토닉스는 상호 연결 전력을 최대 80% 절감하고 랙 내부 발열을 최소화하여 데이터센터 전력효율지수(PUE)를 획기적으로 개선하며, 대규모 슈퍼컴퓨터 한 기당 연간 수백만 킬로와트시(kWh)의 전력을 절약합니다.