シリコンフォトニクスと光インターコネクト:2026年におけるAIデータセンターの帯域幅と電力の壁の克服
クイック回答: 最先端のフロンティアAIモデルの指数関数的スケール拡大は、重大な物理的限界である**「銅線インターコネクトの壁(Copper Wall)」に直面しています。数千基規模のGPUクラスタにおいて、従来の電気銅線ケーブルはわずか2メートルの伝送距離でも激しい熱損失と信号減衰を引き起こし、データセンター総電力の最大30%をデータ転送だけで浪費していました。2026〜2027年、商用実用化を迎えたシリコンフォトニクス(Silicon Photonics)と共パッケージ光学系(CPO: Co-Packaged Optics)**は、銅線の中を流れる電子を半導体パッケージ上のコヒーレントレーザー光子へと置換します。これにより、伝送エネルギーの10分の1削減(1ビットあたりサブピコジュール以下)、ネットワーク遅延の解消、そしてエクサスケール分散AIトレーニングが実現します。
AIモデルのパラメータ数が数十兆規模へと爆発的に増加するにつれ、データセンター設計における最大のボトルネックは演算チップ自体の計算性能(FLOPS)から、アクセラレータ間のインターコネクト帯域幅へとシフトしました。現代の巨大言語モデル(LLM)やMixture-of-Experts(MoE)モデルは、数十万基のGPU間でマイクロ秒単位の超低遅延で膨大なデータを全対全(All-to-All)通信する必要があります。
これまでデータセンターでは、ネットワークスイッチとサーバーを銅線ケーブルで接続する着脱式光トランシーバーが主流でした。しかし、1レーンあたり毎秒1.6テラビット(Tbps)を超える高周波領域では、電気抵抗によって銅線が発熱体となり、深刻な信号劣化と熱暴走を引き起こします。
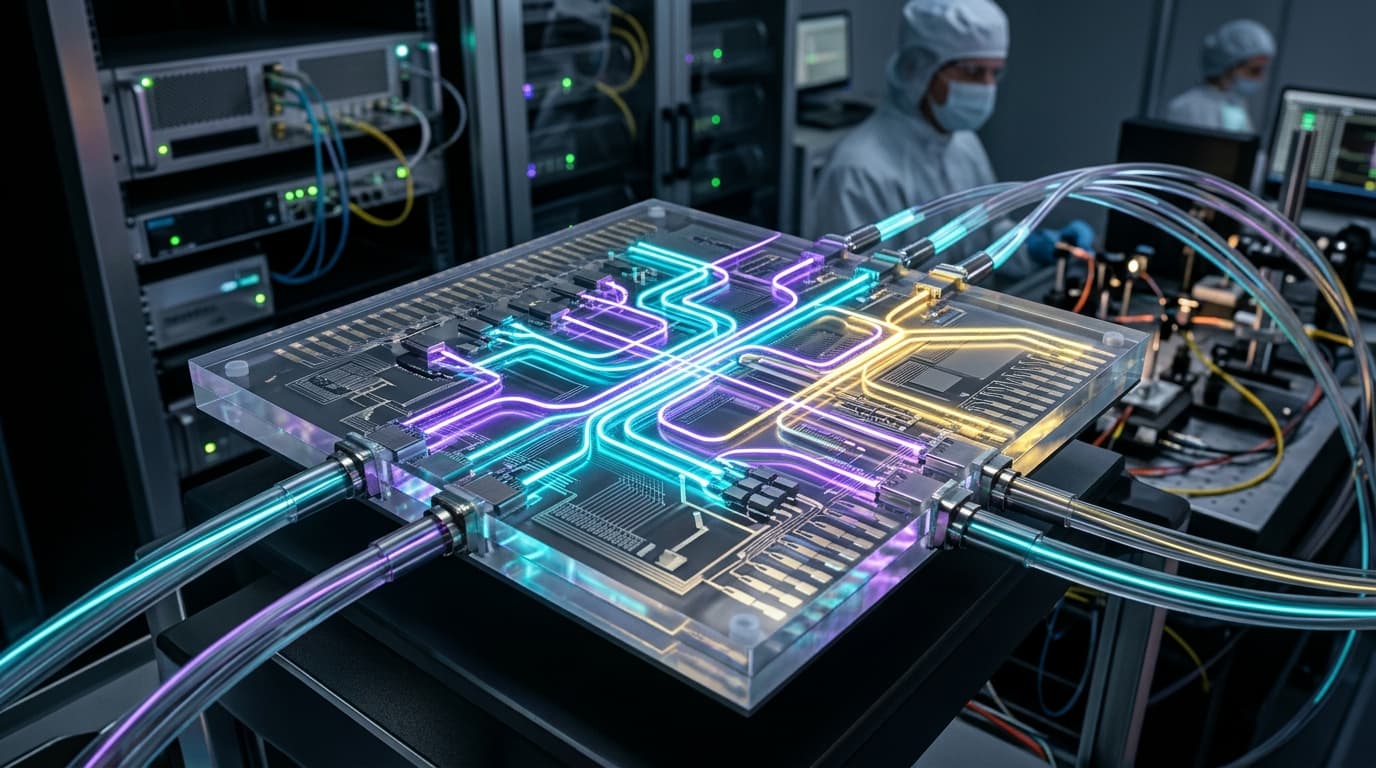
シリコンフォトニクスは、標準的なシリコン半導体製造ライン(CMOS)上で微細な光導波路、光変調器、受光素子をチップ上に直接集積し、光の速度でデータを伝送することでこの限界を根本から解決します。
アーキテクチャの進化:電気銅線配線 vs 共パッケージ光学系(CPO)
シリコンフォトニクスがスーパーコンピュータネットワークをどのように再定義するかを理解するために、GPUラック間の伝送構造の違いを比較します。
従来の電気銅線インターコネクト(熱と距離の物理的限界):
[GPUダイ] ──► [長い基板配線PCBトレース] ──► [着脱式トランシーバー] ──► [太い銅線ケーブル]
                         │ (激しい発熱と 15〜25 pJ/bit の電力損失)
                         ▼
             (2メートル以上の伝送で信号が激しく減衰し破綻)

共パッケージ光学系(CPO)シリコンフォトニクス構造:
[GPU演算チップレット]
         │ (サブミリ単位の超短距離ダイ間インターポーザー接続)
         ▼
[シリコン光エンジン(光導波路 + マイクロリング光変調器)]
         │ (コヒーレントな多波長レーザー光)
         ▼
[直接光ファイバー接続(100メートル以上でも 1 pJ/bit 未満の低消費電力)]
戦略的比較マトリックス:電気銅線配線 vs シリコンフォトニクス
以下の表は、従来の銅線ケーブルと次世代シリコンフォトニクス光インターコネクトの運用特性を対比したものです。
| 評価指標・構造的特徴 | 従来の直接接続銅線(DAC) | 共パッケージ光学系(CPO)シリコンフォトニクス |
|---|---|---|
| 1ビットあたりの伝送消費エネルギー | 15〜25 ピコジュール / ビット(pJ/bit) | 1.0〜2.5 ピコジュール / ビット(次世代はサブpJ) |
| 高速伝送の最大到達距離 | 800G / 1.6T 伝送時で 2 メートル未満 | リピーターなしで 100〜500 メートル以上 |
| ケーブルの重量と配線密度 | 極めて太く重小で、ラック背面のエアフローを阻害 | 非常に軽量・柔軟で、微小な光ファイバーリボンを採用 |
| ネットワーク通信レイテンシ | 複雑なDSPリタイマー回路による遅延が発生 | 光の飛行時間のみで伝送し、DSPリタイマー処理を排除 |
| 半導体製造ファウンドリ技術 | 専用の金属銅線加工・個別組み立て工程 | 標準的な先端CMOSシリコン半導体製造ライン(TSMC / Intel) |
| データセンター冷却システムへの影響 | 強力な空冷ファンおよび高出力液体冷却が必須 | 発熱量が劇的に低下し、直接液冷コールドプレートと好相性 |
2026〜2027年におけるシリコンフォトニクスの3大技術革新
シリコンフォトニクスが実験室レベルの技術から本格的な商用量産データセンターへと移行した背景には、3つの重大な技術革新があります。
1. 共パッケージ光学系(CPO)と2.5D/3D高密度実装
従来の光トランシーバーは、ネットワークスイッチの前面パネルに差し込む独立した大型モジュールでした。電気信号は光に変換される前に、損失の大きいプリント基板(PCB)上を十数センチも走行する必要がありました。CPOは、シリコン光エンジンをGPUやスイッチASICと同じ基板インターポーザー上に直接高密度集積します。電気信号の伝送距離を1ミリ未満に短縮することで、I/O電力消費を70%以上削減します。(関連記事:ニューロモルフィックチップとエッジコンピューティング)
2. 多波長マイクロリング共振器による高密度波長分割多重(DWDM)
物理的なファイバー本数を増やさずに通信帯域を極限まで高めるため、最新の光エンジンはマイクロリング共振器を採用しています。1本の超極細光導波路の中に、異なる16〜32種類のレーザー波長を同時に通し、それぞれ毎秒100Gbpsで変調させることで、1本の光ファイバーで毎秒3.2テラビットの超広帯域伝送を相互干渉ゼロで実現します。(関連記事:光ニューラルネットワークとフォトニックAI)
3. 着脱式外部連続発振レーザー光源(ELS)
初期の光集積チップは、隣接するGPU演算ダイが発生する猛烈な熱によって、レーザー発振素子が劣化する信頼性の課題を抱えていました。2026年の標準規格では、熱源からレーザーを分離し、データセンターラック前面の冷却風が直接当たる位置に着脱式外部レーザー光源(ELS: External Laser Source)を配置します。定偏波光ファイバーを通じて光を演算チップへと供給するため、万一レーザー素子が故障した場合でも、GPUの演算を停止させることなく数秒でホットスワップ交換が可能です。
データセンターの電力問題への影響:メガワット単位の省エネ
巨大ハイパースケーラーや主権国家AIインフラ運用企業にとって、シリコンフォトニクスは事業継続のための生命線です。
- 電力供給枠の限界の突破: ギガワット規模のAIデータセンターキャンパスは、地域の電力網からの割り当て上限に直面しています。シリコンフォトニクスによってデータ伝送にかかる電力を1ビットあたり15〜20ピコジュール削減することで、数万台規模のクラスタ全体で数十メガワットもの電力が節約され、その節約分をすべてAIの純粋な計算処理能力へと振り分けることができます。(関連記事:マクロ資産クラスとしての主権国家AIインフラ)
- 真のメモリ分離(Optical CXL)の実現: サブナノ秒単位の光伝送遅延により、GPUは離れたラックに配置された高帯域幅メモリ(HBM)やDDR5メモリスプールに、あたかもローカルバス上にあるかのように高速アクセスできます。これにより、超巨大MoEモデルのハードウェア稼働効率が劇的に向上します。
- データセンターの自由な物理スケーラビリティ: 超高速光リンクにより、ケーブル長の物理的制約がなくなります。GPUサーバーを複数のフロアや別棟のモジュールに分散配置しても、同一のラック内に収容されているかのような超低遅延ネットワークトポロジーを構築できます。
よくある質問(FAQ)
シリコンフォトニクスと従来の光トランシーバーの最大の違いは何ですか?
従来の光トランシーバーは手作業や精密光学レンズを使って組み立てられた個別モジュールであり、ネットワーク機器の前面パネルに差し込んで使用するため、基板上の長い電気配線によるエネルギー損失が発生します。一方、シリコンフォトニクスは、光導波路や光変調器などのすべての光学素子を標準的なシリコン半導体製造ラインでチップ上に直接製造するため、大幅な小型化、低コスト化、そしてGPUなどの計算チップとの直接集積が可能です。
銅線ケーブルを単に太くするだけでは高速化に対応できないのですか?
銅線を太くすると重量が著しく増大し、サーバーラック背面の配線が物理的に不可能になるだけでなく、冷却に必要な吸排気エアフローを完全に遮断してしまいます。さらに重要な物理的理由として、100GHzを超える超高周波領域では電子が導体の外側表面しか流れなくなる**「表皮効果(Skin Effect)」**が発生し、銅線をどれだけ太くしても信号減衰を食い止めることができません。
シリコンフォトニクスはすでに実際の商用データセンターで稼働していますか?
はい。2026年現在、NVIDIA、Broadcom、Intel、TSMCなどの半導体・ネットワーク大手が商用量産を開始しており、最先端のフロンティアAIモデルをトレーニングする超巨大AIクラスタにおいて、毎秒1.6Tおよび3.2Tの速度で共パッケージ光学系(CPO)や光インターコネクトが本格稼働しています。
シリコンフォトニクスはデータセンターの環境負荷低減にどう貢献しますか?
AIクラスタにおける総電力の約40%は、データ通信と排熱冷却のための電力です。シリコンフォトニクスはインターコネクトの消費電力を最大80%削減し、ラック内の発熱を激減させるため、データセンターの電力使用効率指標(PUE)を大幅に改善し、スーパーコンピュータクラスタ1基あたり年間数百万キロワット時の電力を削減します。